LinkAI 知识库检索策略配置——让 AI 更准地找到你想要的答案
知识库应用的对话效果,一半取决于提示词,另一半取决于检索策略。很多人在"AI 答不对"时只会换模型或改提示词,却忽略了"知识库能不能正确命中问题"这个更底层的问题。
知识库检索的工作流程
用户提问
    ↓
向量化问题(embedding)
    ↓
在向量数据库中搜索语义相近的语料片段
    ↓
根据检索策略筛选出 Top N 个片段
    ↓
把问题 + 选中的语料 + 提示词 一起送给大模型
    ↓
大模型基于这些上下文生成回答
检索策略 就是第 4 步"筛选"的规则——选多少个片段、相似度阈值设多少、关键词匹配和向量匹配怎么配合。配置不当会导致两种常见问题:
- 召回太少 → 答案中信息不全
- 召回太多(或阈值太低) → 把无关内容也塞进去,大模型被噪音干扰
六种检索策略
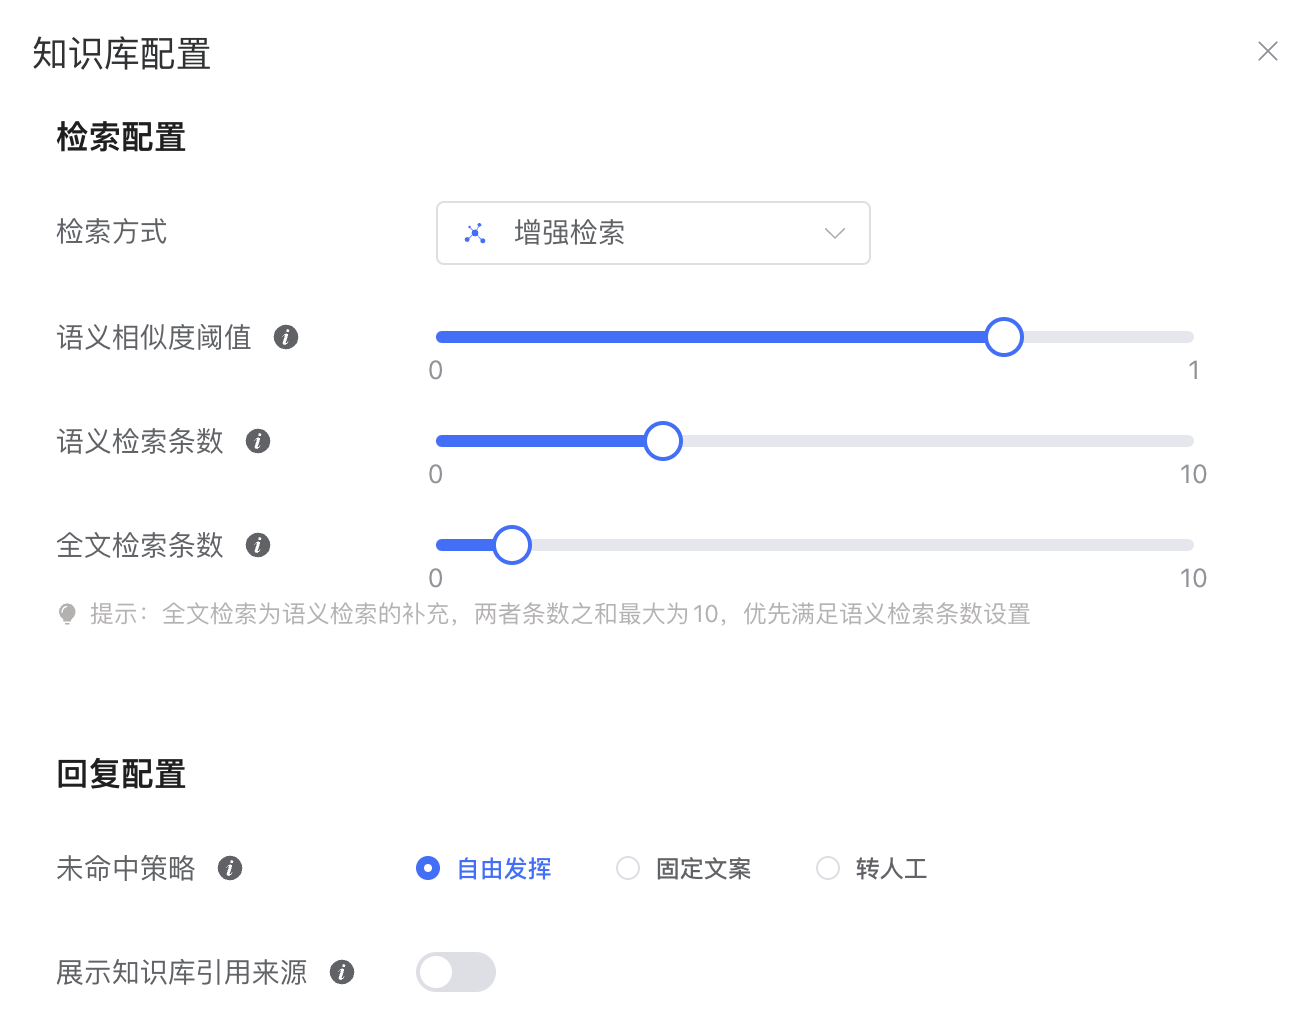
1. 向量语义检索(默认)
最常用的方式——把问题和语料都转成向量,按余弦相似度找最接近的片段。优点是能理解语义("怎么退款"和"我想退这个商品"能命中同一语料),缺点是对字面精确匹配不如关键词。
2. 关键词匹配
传统方式——按问题中的关键词匹配语料。优点是精确,缺点是不理解语义("退款"和"退费"可能命中不同语料)。
3. 混合检索
LinkAI 最推荐的方式——向量语义 + 关键词匹配结合使用,两边结果取并集后再排序。综合了两者的优点,召回率更高。
4. 多路召回 + Rerank
更高级的方式——先用多种检索方式(向量、关键词、标签等)各召回一批候选,再用一个轻量模型对候选进行重排序(Rerank),选出最优的 Top N。适合对精度要求特别高的场景(医疗、法律等)。
5. 热更新召回
当知识库有热更新(上传新文件)时,优先从新内容中检索。适合知识库内容频繁更新的场景。
6. 文档级 vs 片段级
- 文档级召回——找到语义最相关的整篇文档,把整个文档送给模型(上下文窗口够大时适用)
- 片段级召回——找到文档中最相关的片段(200~500 字),只送这些片段(省 token、更快)
LinkAI 默认用片段级召回,适合绝大多数场景。
关键参数
召回数量(Top N)
送给大模型的语料片段数量,默认通常是 5。
- 太小(1~3)→ 信息不全,回答容易缺细节
- 太大(>10)→ 噪音增加,大模型被无关内容干扰
- 推荐 4~8 之间,根据知识库文档的粒度调整
相似度阈值
片段与问题的相似度下限,低于这个值的片段会被丢弃。阈值太高(>0.8)可能把本来相关但表述不同的片段丢掉;阈值太低(<0.5)会塞进来很多噪音。推荐从 0.6~0.7 开始调,用检索测试验证效果后再微调。
检索超时
搜索超过这个时间就跳过,直接用已有的结果。知识库很大时可能需要适当调大。
调参方法论
- 先用默认参数跑检索测试——在知识库详情页输入用户实际会问的问题,看命中的语料是否正确
- 如果检索就不准——先换策略(向量 → 混合),再调 Top N 和阈值
- 如果检索准但回答还是错——问题不在检索,去改提示词或换模型
- 小步迭代——每次只改一个参数,改完立刻跑检索测试验证
与 AI 回答质量的关系
检索策略 → 选中的语料质量 → 大模型回答质量。这一层的效果上限决定了 AI 能"看到"多少正确信息。一个常见的误区是"换更强的模型就能解决"——实际上如果检索没命中正确内容,再强的模型也编不出来正确答案。